
낚시꾼의 의심에서 시작된 궁금증
낚시를 다니다 보면 물고기 이름을 두고 의견이 갈리는 일이 자주 있습니다. 방파제에서 올라온 납작한 물고기 한 마리를 두고 "이건 도다리다", "아니다, 광어 새끼다"로 한참 이야기가 오갑니다. 눈이 왼쪽이면 광어, 오른쪽이면 도다리라는 '좌광우도'로 정리가 되긴 하는데, 강도다리처럼 가자미과인데도 눈이 왼쪽에 몰린 종이 있어서 막상 손에 들고 보면 그것도 헷갈립니다.
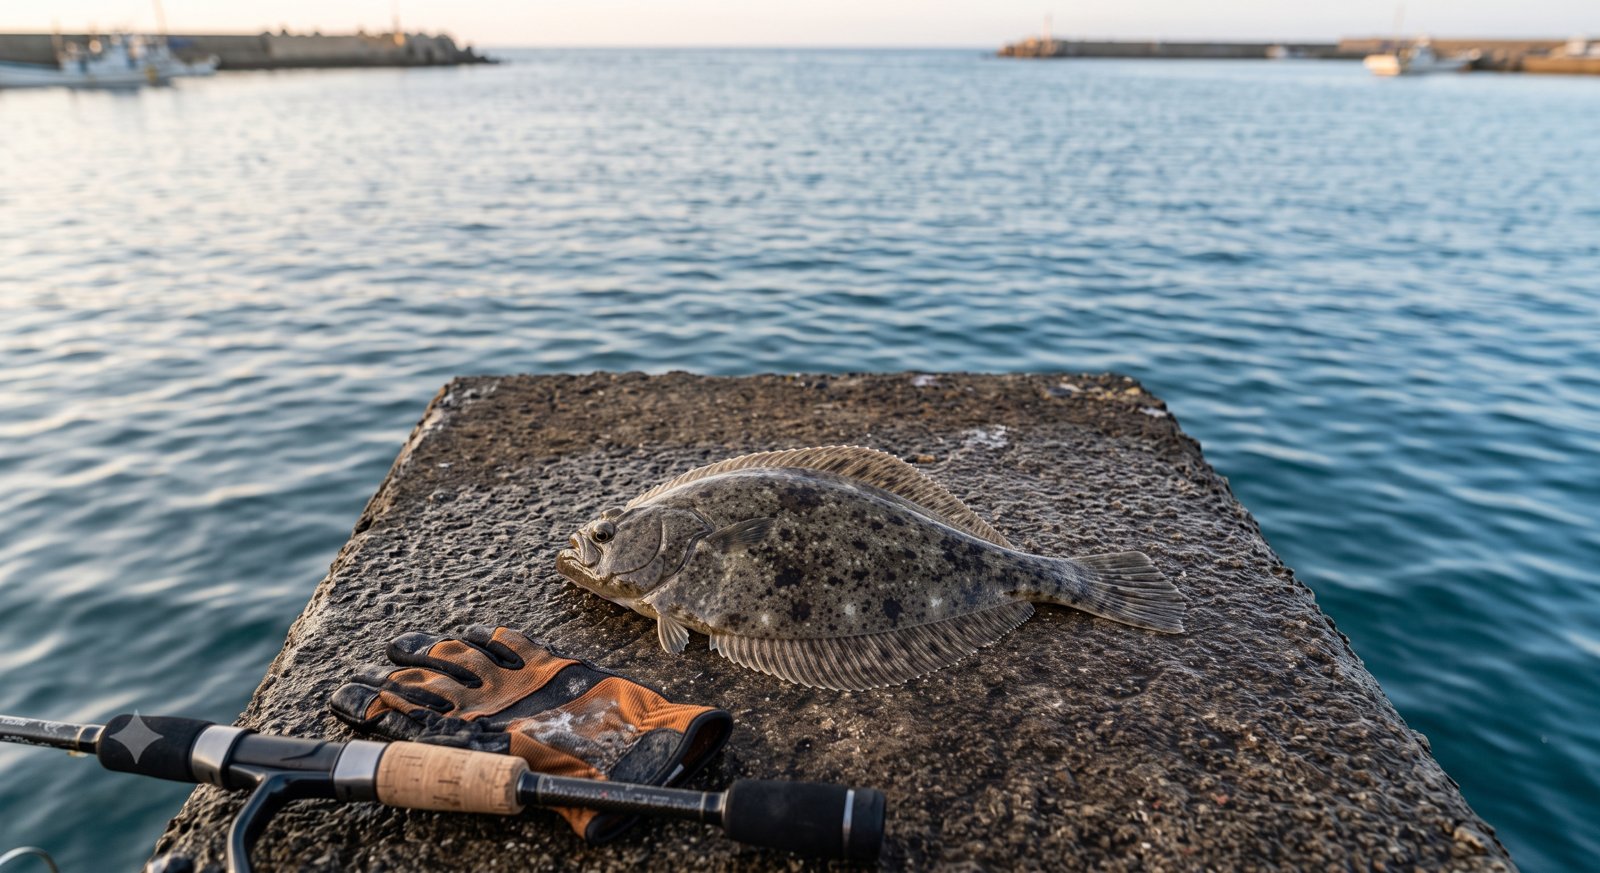
방파제 낚시에서 갓 올린 납작한 물고기, 눈이 몸의 왼쪽으로 몰려 있는 모습
(출처: AI 생성 이미지(Gemini 활용))
넙치와 가자미류는 원래부터 닮았습니다. 둘 다 몸이 납작하고 두 눈이 한쪽으로 몰려 있습니다. 넙치는 눈이 왼쪽에 있고 입이 크며 이빨이 날카롭고, 가자미류는 대개 눈이 오른쪽에 있고 입이 작습니다. 하지만 이런 특징은 온전한 물고기를 손에 들고 볼 때나 통하는 이야기입니다. 앞에서 말한 강도다리 같은 예외가 있고, 어린 물고기는 입이나 이빨 같은 특징이 덜 드러나며, 서로 다른 종 사이에서 난 잡종도 있습니다.
그런데 이 의심은 낚시터에서 끝나지 않습니다. 수산시장 좌판 앞에서, 횟집 수족관 앞에서, 마트 회 코너 앞에서 같은 질문이 따라옵니다. '저 접시 위의 하얀 살은 정말 광어일까, 아니면 값이 더 싼 다른 물고기일까?' 껍질과 머리를 떼어 낸 살점만 보고 종을 가려낼 수 있는 사람은 거의 없습니다. 눈도 입도 없는 살점 앞에서는 겉모습이 아닌 다른 것으로 종을 가려낼 방법이 필요합니다.
이 궁금증에 과학이 내놓은 답이 DNA 바코딩(DNA barcoding)입니다. 상품 바코드를 찍으면 이름과 가격이 뜨듯, 살점 한 조각에서 짧은 유전자 서열을 읽어 데이터베이스와 비교하면 종 이름이 나옵니다. 이 기술이 어떻게 작동하는지, 그리고 개발자인 제가 공개 데이터로 직접 해 본 이야기를 풀어 보겠습니다. 미리 말씀드리면 시장에서 산 물고기를 실제로 검사한 것은 아닙니다. 남이 읽어 미국 국립생명공학정보센터(NCBI)의 GenBank에 올려 둔 서열을 내려받아 BOLD 판별 서비스에 넣어 본, 데이터 조회 쪽의 재현입니다. 광어의 표준명은 넙치라서 아래에서는 넙치로 쓰겠습니다.
수산물 이름 바꿔치기, 얼마나 흔할까?
해양 보호 단체 오세아나(Oceana)는 2010년부터 2012년까지 미국 21개 주의 식당과 소매점 674곳에서 수산물 1,215점을 사서 DNA 검사를 했습니다. 세 점 중 한 점, 33%가 표기와 다른 종이었습니다.
다만 33%라는 숫자를 그대로 받아들이기는 어렵습니다. 오세아나 조사는 식당과 소매점에서 스내퍼나 참치처럼 이름이 자주 바뀐다고 알려진 품목을 골라 사서 시료 단위로 센 값이라, 시장 전체의 비율로 보기에는 높게 나올 수밖에 없습니다. 2019년 학술지 Biological Conservation에 실린 세계 규모 메타 분석은 이런 조사 결과를 그대로 모아 쓰면 오표기 비율이 실제보다 높게 잡힌다고 짚고, 여러 나라의 연구를 제품 단위로 다시 계산했습니다. 그렇게 얻은 평균은 8% 안팎이었고, 95% 신용구간(HDI)은 4~14%였습니다. 신용구간은 분석 모형에서 실제 값이 그 범위 안에 있을 확률이 95%라는 뜻입니다. 이 비율은 나라가 달라도, 도매든 소매든 크게 달라지지 않아 어느 나라에서나 나타나는 문제라는 것을 보여 줍니다. 품목에 따라서는 편차가 컸습니다. 두 조사의 숫자를 한 표에 모으면 이렇습니다.
|
조사
|
대상
|
오표기 비율
|
|
오세아나(2013), 미국 21개 주
|
수산물 1,215점
(자주 바뀌는 품목 위주, 시료 단위) |
33%
|
|
같은 조사, 스내퍼로 팔린 것
|
스내퍼 표기 시료
|
87%
|
|
같은 조사, 붉은 스내퍼(red snapper)로
팔린 것 |
120점
|
120점 중 113점
(진짜는 일곱 점) |
|
같은 조사, 참치로 팔린 것
|
참치 표기 시료
|
59%
|
|
Luque와 Donlan(2019) 메타 분석
|
전 세계 연구를 제품 단위로 다시 계산
|
평균 8%
(95% 신용구간(HDI) 4~14%) |
수산물 오표기 조사 결과
(출처: 오세아나(2013), Luque와 Donlan(2019))
우리나라에서도 이 문제를 다룬 조치가 있었습니다. 식품의약품안전청(지금의 식품의약품안전처)은 2012년 6월부터 참치나 메로로 둔갑해 팔리던 기름치(기름갈치꼬치·흑갈치꼬치)를 식품 원료로 쓸 수 없게 했습니다. 많이 먹으면 사람이 소화하지 못하는 왁스 성분 때문에 복통과 설사 같은 소화기 장애를 일으킬 수 있다는 이유였습니다. 이듬해에는 기름치를 가려내는 유전자 판별법이 국내 연구진 손에서 나왔습니다.
물론 이름이 다르게 붙었다고 모두 같은 문제는 아닙니다. 봄에 '도다리'라 부르는 문치가자미처럼 오래 굳어진 관용 명칭을 쓰는 것은 값 차이를 노리고 다른 종의 이름을 갖다 붙이는 일과는 다릅니다. 홍어와 가오리처럼 뒤섞여 쓰이는 어류 이름을 하나씩 정리하는 국내 연구도 이어지고 있습니다. 다만 국내 유통 실태를 최근에 폭넓게 조사해 공개한 자료는 많지 않습니다.
왜 이런 일이 생길까요? 껍질을 벗기고 살만 남기면 겉모습으로는 구별이 거의 불가능하기 때문입니다. 겉모습으로 안 되니 속을 봐야 하고, 그 속이 바로 DNA입니다.
DNA 바코딩이란 무엇인가?
DNA 바코딩은 2003년 캐나다 궬프대학교의 폴 허버트(Paul Hebert) 연구팀이 제안한 방법입니다. 유전체 전체를 읽는 대신, 종마다 다르면서도 같은 종 안에서는 거의 같은 짧은 구간 하나만 읽어서 '이름표'로 쓰자는 것입니다.
동물에서 이 이름표로 쓰이는 구간은 미토콘드리아 DNA에 있는 COI(cytochrome c oxidase subunit I) 유전자의 앞부분, 염기 약 650개입니다. 왜 이 구간일까요? 미토콘드리아 유전체는 세포 하나에 수백에서 수천 벌씩 들어 있어 냉동이나 조리를 거친 시료에서도 뽑아내기 쉽고, 핵 DNA보다 변이가 빨리 쌓여 가까운 종 사이에도 차이가 벌어져 있기 때문입니다. 어류에서는 2005년 호주 연구팀(Ward 외)이 만든 전용 프라이머로 이 구간을 한 번에 증폭합니다.
핵심은 '바코드 갭(barcode gap)'입니다. 이 호주 연구팀이 어류 207종을 조사한 결과, 같은 종 안에서의 유전거리(K2P 거리, 염기가 바뀌는 방식까지 고려해 계산한 서열 차이)는 평균 0.39%인 데 비해 같은 속의 다른 종 사이는 평균 9.93%였습니다. 이 간격이 있기 때문에 모르는 서열이 들어와도 어느 종에 속하는지 가려낼 수 있습니다.
지느러미나 살점 한 조각에서 DNA를 뽑고, PCR로 COI 구간만 복제해 염기서열을 읽습니다. 그다음부터가 생물정보학이 하는 일입니다. 읽어 낸 서열을 참조 데이터베이스와 대조해 가장 비슷한 서열을 찾는데, 어류 바코드는 BOLD(Barcode of Life Data System)와 NCBI의 GenBank에서 누구나 조회할 수 있습니다. 판정할 때는 일치율 하나만 보지 않습니다. 가장 가까운 후보의 일치율, 그다음 후보와 얼마나 차이가 나는지, 참조 서열이 믿을 만한지(동정이 확실한 표본인지, 여러 레코드가 같은 이름을 가리키는지)를 함께 봅니다. 일치율 98% 안팎을 하나의 눈금으로 흔히 쓰지만 절대적인 값은 아니고, 기관과 분류군에 따라 다르게 잡습니다.
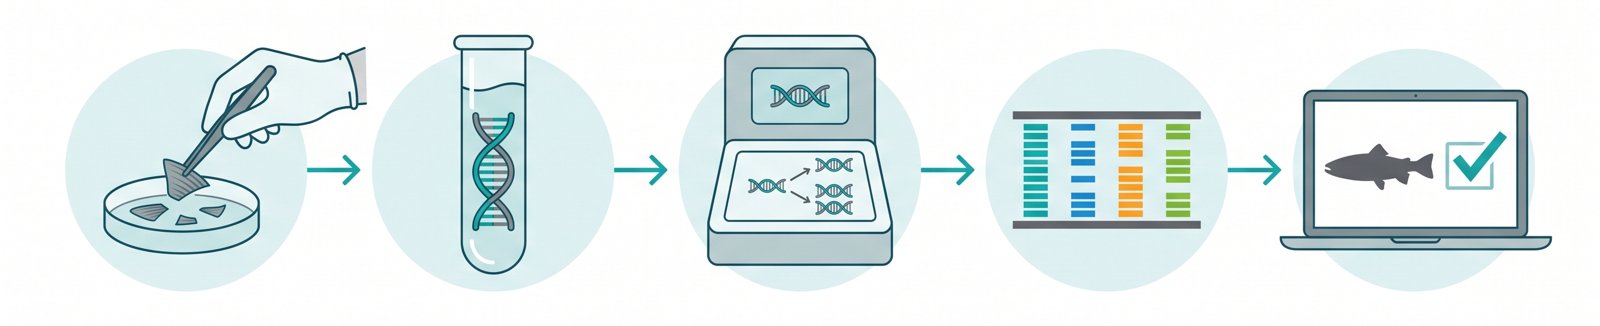
조직 채취에서 종 이름 확인까지 이어지는 DNA 바코딩의 단계
(출처: AI 생성 이미지(Gemini 활용))
물론 만능은 아닙니다. 최근에 갈라져 나온 가까운 종은 COI만으로 구분이 어렵고, 미토콘드리아는 어미에게서만 전해지기 때문에 잡종은 어미 쪽 종만 나옵니다. 통조림처럼 고온 가공을 거친 시료는 DNA가 잘게 끊어져 염기 650개 구간이 통째로는 안 잡히기도 합니다. 참조 데이터베이스에 잘못 등록된 서열이 있으면 결과도 틀립니다. 참조 데이터가 잘 정리돼 있느냐에 판별의 정확도가 달려 있습니다.
종을 가려내는 방법이 DNA 바코딩만 있는 것은 아닙니다. 가장 오래된 방법은 전문가가 생김새를 보고 종을 알아내는 것(동정)이고, 종마다 다른 단백질 무늬를 전기영동이나 질량분석으로 비교하는 방법도 있습니다. DNA를 쓰는 방법 안에서도 특정 종에만 붙는 프라이머로 유무를 확인하는 종특이 PCR, 증폭한 조각을 효소로 잘라 무늬를 비교하는 PCR-RFLP가 먼저 쓰였고, COI 한 구간을 표준으로 정해 공용 데이터베이스와 대조하는 바코딩은 그 뒤에 나왔습니다. 뒤에서 다룰 식품의약품안전처(식약처)의 진위 판별법에도 종특이 PCR을 쓴 방법이 많습니다.
|
방법
|
어떻게 하나
|
장점
|
한계
|
|
형태 동정
|
전문가가 생김새로 판정
|
장비가 필요 없고 빠름
|
살점·가공품에는 못 쓰고,
가까운 종과 어린 개체는 어려움 |
|
단백질 분석(전기영동, 질량분석)
|
종마다 다른 단백질 무늬 비교
|
전기영동은 비교적 간단
|
가열 가공품은 전기영동으로 어렵고,
질량분석은 장비가 비쌈 |
|
종특이 PCR
|
특정 종에만 붙는
프라이머로 유무 확인 |
빠르고 싸며 가공품에도 적용
|
미리 정해 둔 종만 확인 가능
|
|
PCR-RFLP
|
증폭한 조각을
효소로 잘라 무늬 비교 |
시퀀싱 없이 여러 종 구분
|
무늬가 겹치면 구분 못 함
|
|
DNA 바코딩
|
COI 서열을 읽어
참조 데이터베이스와 대조 |
대상 종을 미리 정하지 않아도
되고 참조 자료가 많음 |
시퀀싱이 필요하고, 가까운 종·잡종·
데이터베이스 품질에 좌우됨 |
종을 가려내는 대표적인 방법과 특징
(출처: 자체 제작 및 정리)
개발자가 공개 서열로 직접 해 봤습니다
서열을 읽는 것은 실험이지만, 읽은 서열이 무엇인지 알아내려면 데이터를 조회하고 비교해야 합니다. 개발자가 매일 하는 작업이죠. 그래서 공개 데이터로 직접 해 봤습니다. 제가 잡은 물고기의 서열을 읽을 수는 없으니, 남이 읽어 둔 넙치(Paralichthys olivaceus) 서열을 빌려 판별 과정을 재현했습니다. 비교 상대로는 앞에서 이름이 헷갈린다고 한 두 종, 문치가자미와 강도다리를 골랐습니다.
처음부터 순탄하지는 않았습니다. 예전 자료에 적힌 BOLD 주소로 요청을 보내자, 그 서비스는 2025년 8월에 문을 닫았으니 새 주소를 쓰라는 안내만 돌아왔습니다. 새 API는 서열 제출, 처리 상태 확인, 결과 조회의 세 단계로 나뉘어 있어 코드를 그에 맞게 다시 썼습니다.
아래가 그렇게 고쳐서 돌린 코드입니다. 참고 자료에 적은 GenBank 접근번호(PP897056.1)로 NCBI에서 넙치 COI 서열 한 건을 받아 BOLD 종 판별 API에 제출하고, 판정 결과와 참조 레코드별 일치율을 받아 옵니다. 넙치 한 건을 돌리는 예시이고, 접근번호만 바꾸면 문치가자미(KP835310.1)와 강도다리(LC515810.1)도 같은 코드로 조회됩니다. 따라 해 보시려면 파이썬이 깔려 있어야 합니다. 터미널에 'pip install biopython requests'를 입력해 패키지 두 개를 먼저 설치합니다. 코드를 'fish_barcode.py' 같은 이름으로 저장한 뒤 'python fish_barcode.py'를 입력하면 실행됩니다. 코드 안 'your@email.com'은 본인 주소로 바꿔야 NCBI가 요청을 받아 줍니다. 코드는 넘기고 바로 아래 결과부터 읽으셔도 됩니다.
from Bio import Entrez, SeqIO import requests, time, json
Entrez.email = "your@email.com" # NCBI 요구 사항. 연락 가능한 주소를 넣습니다.
# 1) 넙치 COI 서열 내려받기. 본문에 적은 GenBank 접근번호를 직접 지정합니다.
ACCESSION = "PP897056.1" # 문치가자미 KP835310.1, 강도다리 LC515810.1로 바꾸면 같은 코드로 조회됩니다. record = SeqIO.read(Entrez.efetch(db="nucleotide", id=ACCESSION,
rettype="fasta", retmode="text"), "fasta") #
2) BOLD 종 판별 API에 FASTA 제출
BASE = "https://id.boldsystems.org"
fasta = f">{record.id.split('.')[0]}\n{record.seq}\n"
r = requests.post(f"{BASE}/submission",
params={"db": "public.tax-derep", "mi": 0.8, "mo": 100, "maxh": 10},
files={"fasta_file": ("query.fasta", fasta, "text/plain")}, timeout=120)
r.raise_for_status()
sub_id = r.json()["sub_id"] #
3) 처리 완료까지 대기. 상태 조회는 분당 40회 제한이라 5초 간격으로 최대 60번
status = f"{BASE}/submission/status/{sub_id}"
for _ in range(60):
if requests.get(status, timeout=60).json().get("status") == "complete":
break
time.sleep(5) else:
raise SystemExit("시간 안에 끝나지 않았습니다.") #
4) 판정 결과와 참조 레코드별 일치율 출력
print(requests.get(f"{BASE}/submission/classifications/{sub_id}", timeout=120).json())
res = requests.get(f"{BASE}/submission/results/{sub_id}", timeout=120).text
for key, hit in json.loads(res.splitlines()[0])["results"].items():
print(key.split("|")[0], hit["pident"])
서열 하나를 내려받아 BOLD에 보내고 답이 올 때까지 기다리는 것이 전부입니다. 참조 레코드는 코드의 'maxh' 값으로 열 건까지 받도록 했습니다. 서열 이름표에 공백이나 괄호를 쓰면 제출이 거부된다는 것은 오류를 몇 번 받고서야 알았습니다.
결과는 어땠을까요? 넙치 쪽은 깔끔했습니다. 염기 655개짜리 서열을 넣으니 BOLD는 넙치라고 답했고, 신뢰도는 100점 만점에 100.0이었습니다. 여기서 신뢰도는 그 종일 확률이 아니라, 가장 비슷한 참조 레코드들이 얼마나 한 목소리로 같은 이름을 가리키는지 매긴 점수입니다. 다른 이름이 하나라도 섞이면 내려갑니다. 받아 온 열 건 중 아홉 건이 넙치로 등록된 레코드였고, 한 건은 속까지만 이름이 붙어 있었습니다. 일치율은 모두 99.5% 이상이었습니다.
앞에서 봄 도다리로 소개한 문치가자미(Pseudopleuronectes yokohamae) 서열은 조금 다르게 나왔습니다. 판정은 문치가자미가 맞았지만 신뢰도는 94.4였습니다. 열 건 중 아홉 건이 문치가자미였고, 여덟 번째로 가까운 한 건이 같은 속의 다른 종인 감성가자미(Pseudopleuronectes obscurus)였기 때문입니다. 그런데 그 한 건의 일치율이 98.8%로, 흔히 쓰는 98% 눈금을 넘습니다. 일치율 하나만 들고서는 가까운 종을 갈라내기 어렵고, 그다음 후보와의 차이와 참조 레코드의 구성을 같이 봐야 한다는 말이 이런 뜻입니다.
세 번째로 넣은 것은 도입부에서 좌광우도의 예외로 말한 강도다리(Platichthys stellatus)입니다. 여기서는 BOLD가 한 걸음 물러섰습니다. 종을 확정하지 않고 속(Platichthys)까지만 답했고, 신뢰도는 90.0이었습니다. 상위 열 건 중 여덟 건은 강도다리였지만, 100% 일치로 맨 윗자리에 나란히 선 네 건 안에 돌가자미와 강도다리 사이에서 난 잡종 레코드 한 건과 종 이름이 붙지 않은 레코드 한 건이 함께 들어와 종 이름이 한 곳으로 모이지 않았기 때문입니다. 그래서 BOLD는 잡종 한 건을 뺀 아홉 건이 함께 쓰는 속 이름까지만 답했습니다. 잡종과 종 이름 없는 레코드는 잘못 올라온 자료가 아니라 있는 그대로를 적어 둔 기록인데, 이런 서열이 가까이 있으면 판정이 한 단계 물러섭니다.
세 서열의 결과를 한 표에 모았습니다. 위에서 아래로 갈수록 신뢰도가 내려가는데, 이 세 건에서는 제출한 서열의 품질보다 상위 열 건에 어떤 이름의 레코드가 섞여 있었는지가 점수 차이를 갈랐다고 보는 것이 맞겠습니다. 세 점수 모두 원본 조회 결과에서 다시 확인한 값입니다. 접근번호는 참고 자료에 적어 두었습니다.
|
제출한 서열
|
BOLD 판정
|
신뢰도
(100점 만점) |
상위 열 건 구성
|
일치율 범위
|
|
넙치
(염기 655개) |
넙치, 종 수준
|
100.0
|
넙치 아홉 건, 속까지만 이름 붙음 한 건
|
99.5~100%
|
|
문치가자미
(염기 604개) |
문치가자미, 종 수준
|
94.4
|
문치가자미 아홉 건, 같은 속 다른 종 한 건
|
98.7~100%
|
|
강도다리
(염기 619개) |
강도다리속(Platichthys), 속 수준
|
90.0
|
강도다리 여덟 건, 잡종 한 건, 종 이름 없음 한 건
|
99.5~100%
|
세 서열의 BOLD 종 판별 결과
(출처: 자체 제작 및 분석)
살점으로는 구별이 안 되던 세 물고기가 서열 위에서는 서로 다른 자리에 놓였고, 참조 데이터의 상태에 따라 판정의 확신 정도도 달라졌습니다. NCBI의 서열 검색 도구인 BLAST에 넙치 서열을 직접 넣어 봤을 때도 상위 열 건 안에 넙치와 범가자미 사이에서 난 잡종이 하나 끼어 있었습니다. 앞에서 잡종은 어미 쪽 종으로 나온다고 했는데, 그 예가 바로 눈앞에 있었습니다.
한편 조회 결과는 거의 같은 종으로만 채워져 있어서 종 사이의 간격은 눈에 들어오지 않았습니다. 그래서 세 종의 서열을 나란히 놓고 염기 600개 남짓을 직접 맞대어 봤습니다. 넙치와 문치가자미의 COI 일치율은 약 83%, 넙치와 강도다리는 약 85%, 같은 가자미과인 문치가자미와 강도다리는 약 93%였습니다. 종마다 한 마리씩 골라 견준 값이라 일반화할 수는 없지만, 같은 종 안에서는 98.6% 이상으로 붙고 다른 종과는 83~93%로 벌어지는 모습이 이 세 서열에서도 그대로 나타났습니다. 여기서 일치율은 두 서열을 맞대어 같은 자리의 염기가 같은 비율이고, 앞에서 본 0.39%와 9.93%는 K2P 유전거리라 계산법이 달라 두 숫자를 곧바로 견줄 수는 없습니다. 다만 가까운 종일수록 간격은 빠르게 좁아져서, 앞에서 본 감성가자미처럼 같은 속 안에서는 98.8%까지 붙습니다.
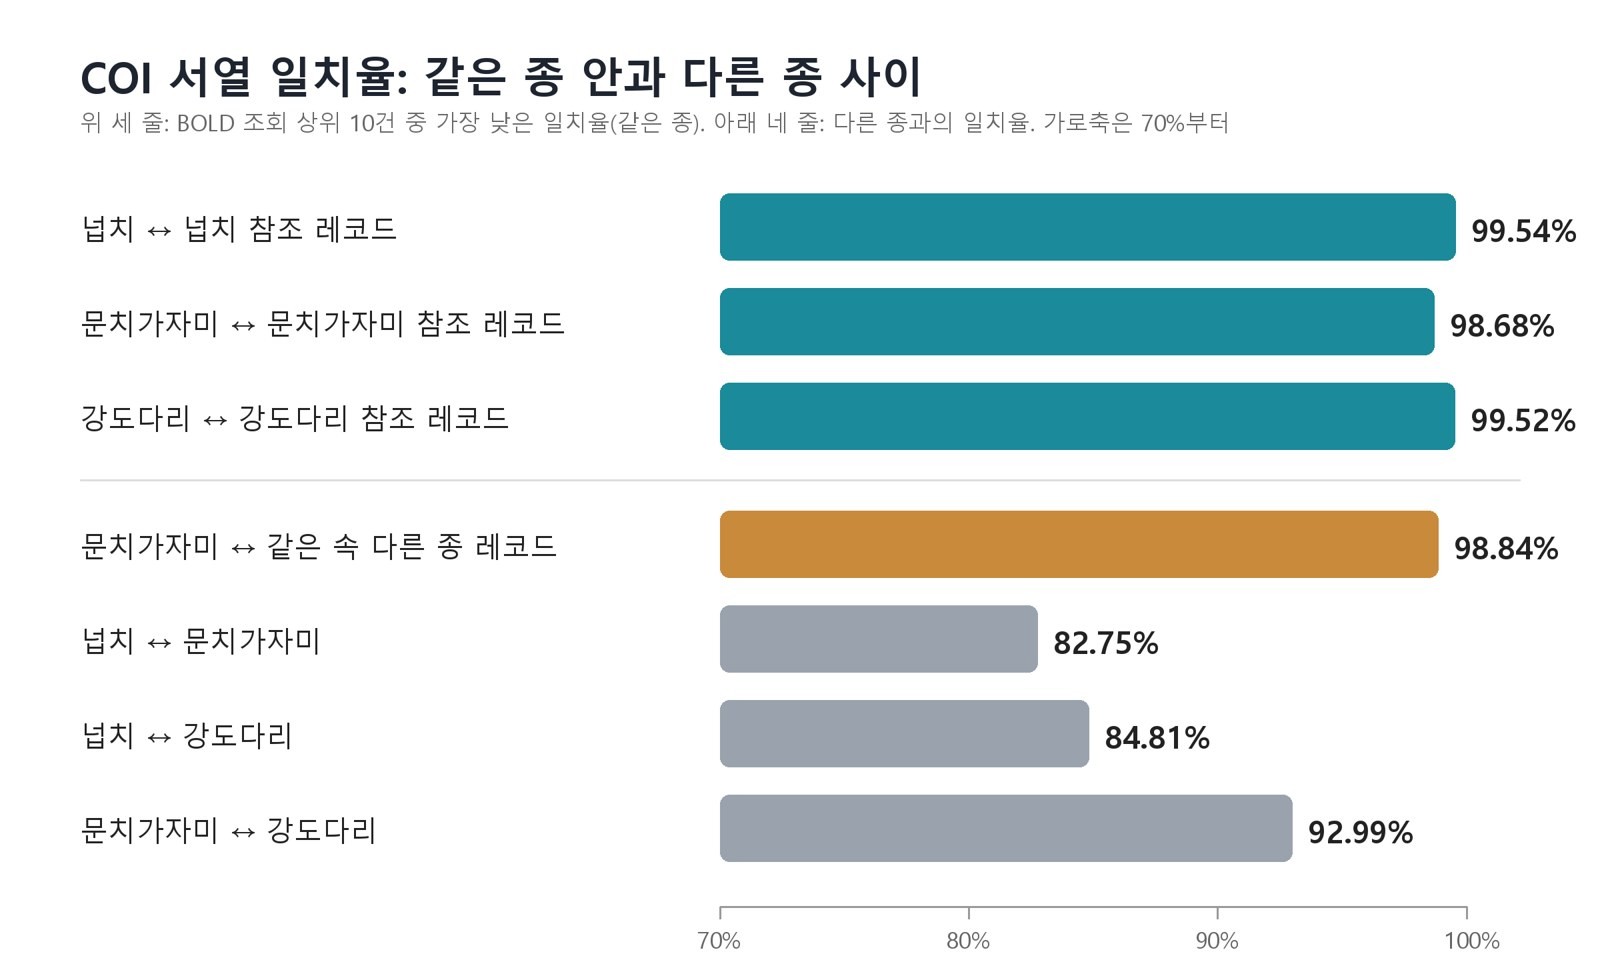
같은 종 안과 다른 종 사이의 COI 서열 일치율 비교
(출처: 자체 제작, NCBI GenBank·BOLD 데이터 기준)
여기까지 해 두면 서열 입력창과 결과 화면을 붙여 혼자 쓸 작은 도구로 만드는 것은 어렵지 않습니다. 코드가 부담스러우신 분은 BOLD 사이트에 서열을 붙여 넣기만 해도 같은 결과를 보실 수 있습니다.
바코딩은 어디까지 왔나?
유전자로 종을 가려내는 일은 이제 연구실 밖으로 나와 있습니다. 식품의약품안전처는 2011년부터 겉모습으로 구별하기 어려운 식품 원료를 유전자로 가려내는 진위 판별법을 만들어 왔는데, 여기에는 대구와 명태, 다랑어류, 앞에서 말한 기름치 같은 어류가 들어 있습니다.
국립수산과학원은 2016년에 주요 수산생물 600여 종의 DNA 바코드를 정리해 종과 원산지를 가리는 수산물 유전자 감식정보 검색시스템을 갖췄고, 국립생물자원관은 한반도 생물의 9만 건이 넘는 DNA 바코드 자료를 공공데이터포털에 열어 두었습니다. 누구나 내려받아 볼 수 있습니다. 미국 식품의약국(FDA)도 수산물 종 판별에 DNA 바코딩을 공식 방법으로 쓰고 있습니다.
종을 가려내는 장비도 실험실 밖으로 나오는 중입니다. 손바닥만 한 휴대용 나노포어 시퀀서(옥스퍼드 나노포어의 MinION)로 그 자리에서 서열을 읽고 바로 데이터베이스와 대조하는 방식이 식품 검사 연구에 쓰이기 시작했습니다. 네덜란드 연구진은 2019년 현장 검사에 쓸 수 있는지 보려고 어류 혼합 시료를 이 장비로 읽었는데, 실험실 장비로 얻은 결과와 거의 같게 종을 가려냈습니다. 싱가포르 연구진은 2020년 학술지 Food Control에 실은 논문에서 시장에서 산 수산물을 같은 장비로 판별해, 가자미류로 팔리던 것이 실제로는 여러 종이었다는 것과 오징어볼에 들어간 돼지 DNA까지 찾아냈습니다. 방파제에서 지느러미 한 조각으로 현장에서 답을 보는 날도 멀지 않아 보입니다.
한계도 분명합니다. 바코딩은 '무엇인가'는 알려 주지만 '어디서 왔는가'는 알려 주지 않습니다. 국산 넙치와 수입 넙치는 같은 종이라 COI 서열로는 구분하기 어렵습니다. 원산지까지 가리려면 집단마다 빈도가 다른 단일염기다형성(SNP) 마커처럼 유전체를 더 넓게 읽는 도구가 필요합니다.
유전체를 넓게 읽으면 종을 가르는 데서 한 걸음 더 나아가, 같은 종 안에서 어느 개체가 더 잘 자라고 더 잘 견디는지도 가늠할 수 있습니다. 이것이 디지털 육종입니다. 넙치는 국내 해산어류 양식의 대표 어종입니다. 인실리코젠은 제주대학교가 주관하는 수산종자 디지털 육종 국가 과제에 공동연구기관으로 참여해 유전자형과 형질 데이터를 한자리에서 다루는 시스템을 만들고 있습니다. 살점 한 조각의 이름을 찾는 일도, 수만 마리 중 좋은 어미를 고르는 일도 잘 정리된 DNA 데이터베이스 위에서 돌아갑니다.
마치며
이 글은 방파제 위의 작은 논쟁에서 시작했습니다. 이 물고기가 광어냐 도다리냐 하는 질문이었죠. 살점 앞에서는 전문가도 답하기 어려운 이 질문에 DNA 바코딩은 염기 650개짜리 서열로 답을 냅니다. 그 뒤에는 20년 넘게 전 세계 연구자들이 쌓아 온 참조 데이터베이스가 있습니다. 다음에 횟집에서 광어를 주문하실 때 접시 위 하얀 살점 뒤에 이런 이야기가 있다는 것을 떠올려 보시면 좋겠습니다. 그리고 낚시터에서 물고기 이름 논쟁이 붙으면, 이제 이렇게 말하셔도 됩니다. "지느러미 한 조각만 있으면 알아낼 방법이 있는데."
참고자료
- 식품의약품안전청. (2012. 5. 30.). 참치와 비슷한 기름치, 6월부터 식품원료로 사용금지! 보도자료. 2026년 9월 11일 접속, https://www.korea.kr/briefing/pressReleaseView.do?newsId=155830816
- 식품의약품안전청. (2012. 12. 18.). 식품중 사용원료 진위판별 지침서Ⅱ: 유전자분석법 활용(대구·명태·다랑어류·기름갈치꼬치 등 어류 판별법 수록). 2026년 9월 14일 접속, https://www.korea.kr/archive/expDocView.do?docId=33285
- 식품의약품안전처. (2016. 3. 9.). 식약처, 유전자 분석 식품원료 진위 판별법 개발. 보도자료. 2026년 9월 11일 접속, https://www.korea.kr/briefing/pressReleaseView.do?newsId=156114157
- 박용춘 외. (2013). 식품원료로 사용금지 대상인 기름치(기름갈치꼬치 및 흑갈치꼬치) 판별법 개발. 한국식품위생안전성학회지, 28(1), 50–55. https://doi.org/10.13103/JFHS.2013.28.1.050
- 한경호 외. (2022). 국내에 수입되는 어류의 코드 부여를 위한 목록 재정립. 한국수산과학회지, 55(3), 353–373. https://doi.org/10.5657/KFAS.2022.0353
- 국립수산과학원. 이전 우수성과: 주요 수산생물 600여 종 종 분류 및 바코드화, 수산물 유전자 감식정보 검색시스템 구축. 2026년 9월 11일 접속, https://www.nifs.go.kr/contents/actionContentsCons0073.do
- 국립생물자원관. 기후에너지환경부 국립생물자원관_DNA 바코드_20250910(공공데이터포털, 92,545건). 2026년 9월 11일 접속, https://www.data.go.kr/data/15067608/fileData.do
- 국립해양생물자원관. 해양생명자원 통합정보시스템(MBRIS) 감성가자미(Pseudopleuronectes obscurus) 종 정보. 2026년 9월 30일 접속, ttps://www.mbris.kr/
- 통계청(현 국가데이터처). (2023. 3. 24.). 2022년 어류양식동향조사 결과 잠정치(넙치류가 해산어류 양식 생산량의 50.5%). 2026년 9월 14일 접속, https://mods.go.kr/board.es?act=view&bid=225&list_no=424510&mid=a10301080400
- 해양수산과학기술진흥원(KIMST). 수산종자산업 디지털혁신 기술개발사업 내역사업 '수산종자 디지털 육종 플랫폼 구축'(2022~2028년, 주관 제주대학교). 과제 공고 자료.
- NCBI. Entrez Programming Utilities (E-utilities) Help. 2026년 9월 10일 접속, https://www.ncbi.nlm.nih.gov/books/NBK25501/
- NCBI GenBank. 접근번호 PP897056.1(넙치)·KP835310.1(문치가자미)은 2026년 9월 10일, LC515810.1(강도다리)은 2026년 9월 11일 접속. https://www.ncbi.nlm.nih.gov/nuccore/
- NCBI BLAST(megablast, nt 데이터베이스). 본문의 넙치 상위 열 건은 필자 직접 조회. 2026년 9월 10일 접속, https://blast.ncbi.nlm.nih.gov/Blast.cgi
- BOLD Systems. Barcode ID API documentation(본문 판정은 public.tax-derep 라이브러리 기준, 넙치·문치가자미 2026년 9월 10일, 강도다리 2026년 9월 15일 판별 조회). 2026년 9월 11일 접속, https://id.boldsystems.org/docs
- 오세아나(Oceana). (2013). Oceana Study Reveals Seafood Fraud Nationwide(미국 21개 주 수산물 1,215점 DNA 검사 보고서). 2026년 9월 10일 접속, https://oceana.org/reports/oceana-study-reveals-seafood-fraud-nationwide
- Luque와 Donlan. (2019). 수산물 오표기 세계 메타 분석(제품 단위 평균 8%). Biological Conservation, 236, 556–570. https://doi.org/10.1016/j.biocon.2019.04.006
- Hebert 외. (2003). DNA 바코딩을 처음 제안한 논문. Proceedings of the Royal Society B, 270, 313–321. https://doi.org/10.1098/rspb.2002.2218
- Ward 외. (2005). 호주 어류 207종 DNA 바코딩(같은 종 0.39%, 같은 속 다른 종 9.93% 수치의 출처). Philosophical Transactions of the Royal Society B, 360, 1847–1857. https://doi.org/10.1098/rstb.2005.1716
- 미국 식품의약국(FDA). DNA 기반 수산물 종 판별 안내 페이지. 2026년 9월 10일 접속, https://www.fda.gov/food/reference-databases-and-monitoring-programs-food/dna-based-seafood-identification
EDITOR
김성도
Daejeon Branch · Junior Developer
'STORAGE' 카테고리의 다른 글
| 아프지 않아서 모르는 손상! 유모세포의 정체와 청력을 지키는 법 (0) | 2026.09.18 |
|---|---|
| [2026 IPA 시리즈 제8편] "이 경로가 왜 여기 있지?" — 질문을 분석으로 바꾸는 IPA Investigator (0) | 2026.09.17 |
| 수면의 과학 — 피곤한데 왜 잠은 안 올까? (0) | 2026.09.03 |
| [2026 IPA 시리즈 제7편] 내 데이터, 더 빠르게 읽고 공유하기 — AI와 함께 읽는 IPA Interpret (0) | 2026.08.27 |
| 끝나지 않은 식중독 시즌 — 식중독균의 정체와 예방법 (0) | 2026.08.24 |


댓글