
지난 편에서는 분석이 끝난 뒤에 남는 일들을 IPA Interpret이 어떻게 줄여주는지 살펴봤습니다. 그림을 다듬고, 결과의 큰 방향을 요약하고, 링크 하나로 공유하는 과정이었습니다. 그런데 결과를 읽다 보면 조금 다른 종류의 막힘도 찾아옵니다. 결과는 나왔지만, 그 결과가 예상과 달라서 다음으로 넘어가지 못하는 경우입니다.
“분석을 잘못한 걸까, 아니면 내가 모르는 이유가 있는 걸까?” 이 질문 앞에서 한참 멈춰 서게 되는 순간이 있습니다.
결과 화면 앞에서 생기는 질문
(출처: AI 생성 이미지(Gemini Nano Banana 2 활용))
예를 들어 줄기세포를 심근세포로 분화시키는 실험 데이터를 분석했는데, 결과 목록 상위에 뼈 무기질화(Bone Mineralization) 관련 경로가 나타났다고 해보겠습니다. 뼈 계통이 아닌 심근 세포를 다루고 있었는데 말입니다!
기존에는 이런 의외의 결과를 해석하기 위해 경로에 어떤 유전자들이 포함되어 있는지 하나씩 확인하고, 관련 문헌을 찾아보면서 결과의 의미를 직접 추적해야 했습니다. 또한, 분석 결과와 검색 자료를 오가며 원인을 확인하는 데에도 시간이 필요했습니다.
이번 편에서 소개할 IPA Investigator (Beta)는 바로 이 단계를 돕는 기능입니다. 2026년 여름 릴리즈에 새로 들어온 대화형 AI 에이전트로, 결과 화면을 열어둔 채 그대로 질문을 던질 수 있습니다.
실제로 어떻게 묻고 답을 받는지, 그리고 그 답이 어떻게 분석으로 이어지는지 세 가지 상황을 따라가며 살펴보겠습니다.
1. 분석 결과를 열어둔 채 묻기 — Core Analysis
2. 결과 창 없이 묻기 — Open Question
3. 비교 분석 결과를 나란히 놓고 묻기 — Comparison Analysis
지금 열려 있는 화면을 함께 보는 채팅 패널
IPA Investigator는 IPA 데스크톱 오른쪽에 붙는 채팅 패널입니다. 패널을 열면 “What are you researching today?”라는 문장과 함께 입력창이 하나 놓여 있습니다.

IPA Investigator 시작 화면
(출처: QIAGEN IPA and IPA Interpret Summer (2026) Release Notes)
일반적인 챗봇과 구분되는 지점은 지금 열려 있는 결과 창을 맥락으로 읽는다는 데 있습니다. Core Analysis나 Comparison Analysis, 네트워크 창이 열려 있으면 그 내용을 바탕으로 답하고, 창이 여러 개면 맨 앞에 있는 창을 기준으로 삼습니다.
열린 창이 하나도 없으면 일반적인 과학 질문으로 받아들이고 답합니다. 덕분에 결과를 다시 설명하거나 표를 복사해 붙여 넣을 필요가 없습니다. 질문은 어떤 언어로든 입력할 수 있어, 한국어로 묻고 한국어로 답을 받는 것도 가능합니다.
1. 분석 결과를 열어둔 채 묻기 — Core Analysis
QIAGEN이 릴리즈 노트에서 든 예시는 앞서 말한 상황과 같습니다. 인간 줄기세포를 심근세포로 분화시키는 실험에서, 아주 초기 시점의 RNA-seq 데이터를 Core Analysis로 분석했습니다. 상위에 올라온 경로는 다음과 같았습니다.
| Canonical Pathway | p-value |
| Formation of definitive endoderm | 4.43E-13 |
| Bone Mineralization Signaling Pathway | 4.47E-12 |
| Metallothioneins bind metals | 7.87E-09 |
| Transcriptional Regulatory Network in Embryonic Stem Cells | 1.67E-08 |
| Zn Homeostasis Signaling Pathway | 1.83E-08 |
발현 변화를 일으켰을 법한 원인 쪽을 추정하는 Upstream Regulator 항목에는 SOX2(억제 예측), tretinoin, BMP4, WNT3 A(활성 예측), POU5F1이 올라와 있었습니다. SOX2와 POU5F1은 세포를 미분화 상태로 붙들어 두는 전사인자이고, BMP4와 WNT3A는 분화 방향을 지시하는 신호 물질입니다. 줄기세포가 막 분화를 시작한 상황이라는 맥락에는 잘 맞는 후보들입니다.
그런데 2위의 Bone Mineralization Signaling Pathway는 선뜻 설명되지 않습니다. 분화 1일 차 세포가 벌써 뼈를 만들고 있다고 보기는 어렵기 때문입니다. 이때 결과 창을 열어둔 채, 오른쪽 패널에 그대로 물어봅니다.
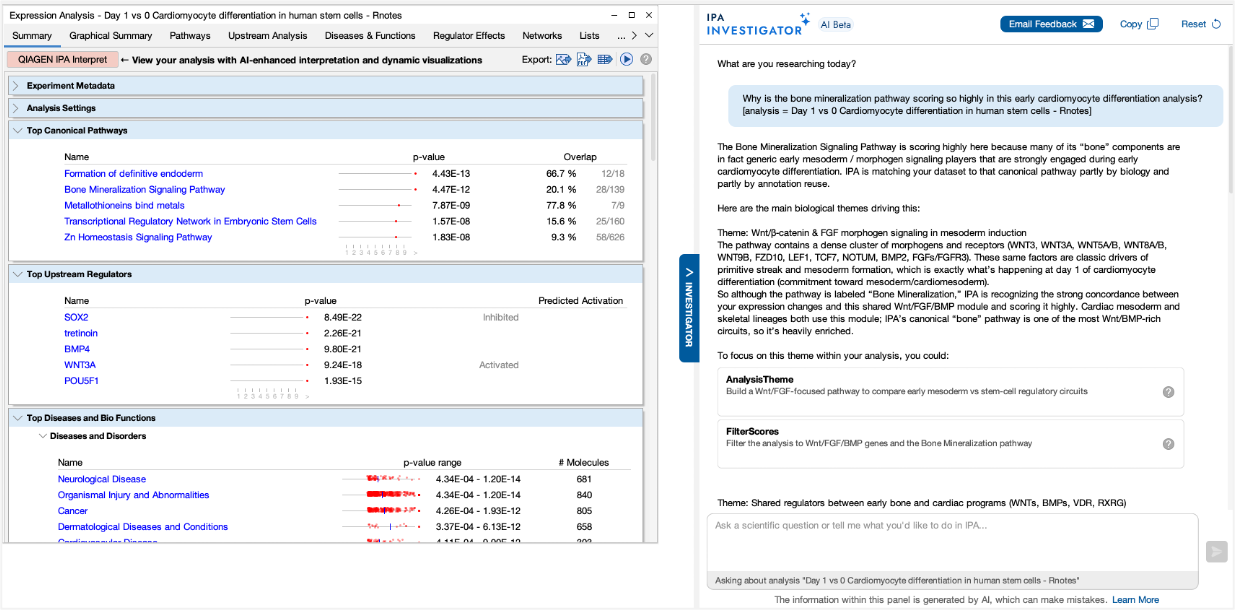
Core Analysis를 열어둔 상태에서 IPA Investigator에 질문하기
(출처: QIAGEN IPA and IPA Interpret Summer (2026) Release Notes)
Investigator의 답변은 이 경로에 들어 있는 유전자 상당수가 뼈에만 쓰이는 것이 아니라는 점을 짚었습니다. Bone Mineralization Signaling Pathway 안에는 WNT3, WNT3A, WNT5A/B, WNT8B, FZD10, LEF1, TCF7, NOTUM, BMP2, FGFR3 같은 분자들이 관여합니다. 여기서 WNT·BMP·FGF는 세포가 어느 방향으로 변할지를 알려주는 신호 물질입니다.
여기서 중요한 점은 심장과 여러 근골격계 조직은 발생 과정에서 중배엽(mesoderm) 계통에서 유래한다는 것입니다. 배아 초기에는 세포가 세 개의 배엽으로 나뉘며, 이 중 가운데 층을 중배엽이라고 부릅니다. 심장과 많은 근골격계 조직은 이 단계에서 시작됩니다. 즉 분화 1일차 세포가 지금 하고 있는 일은 '심장이 되는 것'이 아니라, 그 전 단계인 '중배엽이 되는 것'에 가깝습니다. 따라서 다음과 같은 흐름을 생각해볼 수 있습니다.
- 분화 초기 세포에서 WNT·BMP·FGF 신호가 활발하게 움직임
- 이 신호 물질들이 뼈 무기질화 경로에도 구성 유전자로 등록되어 있음
- 그 결과 ‘뼈’라는 이름의 경로가 상위에 함께 나타남
같은 드라이버와 망치가 책장을 만들 때도, 의자를 만들 때도 쓰이는 것과 비슷합니다. 공구 사용 기록만으로 무엇을 만들었는지 단정하기는 어려운 셈입니다.
즉, 경로의 이름이 곧 내 데이터의 생물학을 뜻한다고 보기는 어렵다는 이야기입니다. 물론 이 설명도 확인이 필요한 해석 중 하나이지, 결론은 아닙니다. 그리고 Investigator는 이 지점에서 대화가 실제 분석으로 넘어갑니다.
대화가 그대로 다음 분석이 됩니다
IPA Investigator는 답변 아래에 Action Card를 함께 제시합니다. 설명에서 곧바로 실행할 수 있는 IPA 작업을 카드 형태로 묶어둔 것입니다. 이번 사례에서 제안된 것은 두 가지였습니다.
- AnalysisTheme — 방금 설명한 주제, 즉 “중배엽 유도에서의 Wnt/β-catenin & FGF 신호”를 요약하는 네트워크 생성하기
- FilterScores — Wnt/FGF/BMP 계열 유전자와 뼈 무기질화 경로가 드러나도록 분석 결과를 필터링하기
Action Card를 실행하기 전에 오른쪽 “?” 아이콘에 마우스를 올리면 그 액션이 IPA에서 어떤 단계를 수행하는지 미리 확인할 수 있습니다. 무엇이 실행될지 확인한 뒤 실행 여부를 정할 수 있는 셈입니다.
AnalysisTheme을 실행하면 IPA가 네트워크를 그려 띄웁니다. 화면에는 EOMES, FGFR3, WNT3, WNT3A 등이 놓이고, 각 유전자의 발현 변화에 따라 색상이 입혀집니다. 그리고 이 분자들이 내배엽 형성, 상피-중간엽 전환 조절 경로, 배아줄기세포 전사 조절망, 그리고 문제의 뼈 무기질화 경로와 어떻게 이어지는지가 한 화면에 정리됩니다.
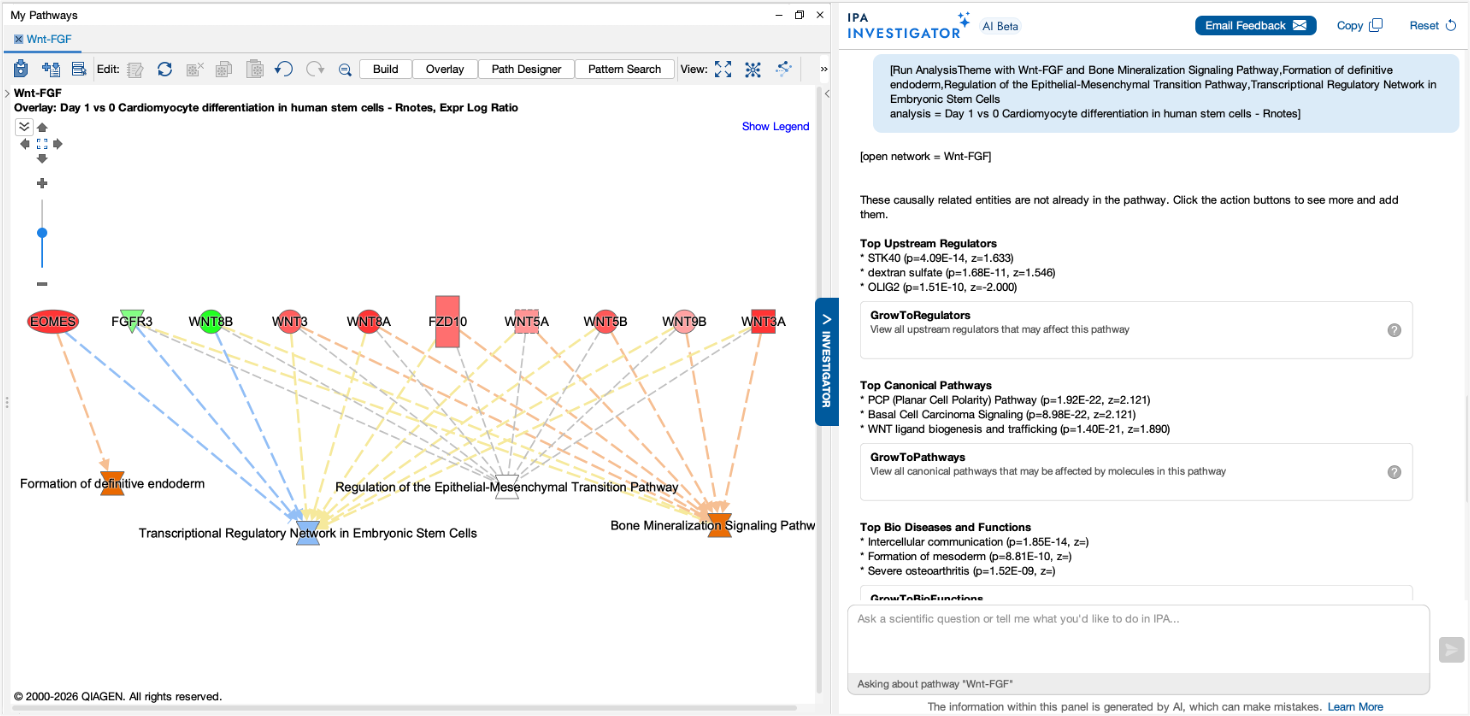
AnalysisTheme 액션으로 생성된 Wnt-FGF 네트워크
(출처: QIAGEN IPA and IPA Interpret Summer (2026) Release Notes)
이 네트워크를 그린 것은 AI가 아니라 IPA입니다
여기서 짚어둘 구분이 있습니다. Investigator가 한 일은 IPA에 “이 유전자들로 네트워크를 그려달라”는 입력값을 넘긴 것입니다. 화면에 그려진 분자 사이의 연결선은 QIAGEN Knowledge Base에 축적된 문헌 근거에서 나옵니다. 연구자가 직접 메뉴를 눌러 만들었을 때의 결과와 같습니다.
대화가 손을 대신했을 뿐, 근거가 바뀐 것은 아닙니다. 실행하고 나면, IPA는 다음 단계에 해볼 만한 작업을 다시 제안합니다. 네트워크가 만들어지면 그 네트워크를 기준으로 인과 분석을 한 번 더 수행하고, 아직 네트워크에 들어 있지 않지만 통계적으로 의미 있어 보이는 항목을 종류별로 정리해 보여줍니다.
Grow로 시작하는 작업 카드는 지금 그려진 네트워크에 관련 항목을 이어 붙여 넓힌다는 뜻의 IPA 기능입니다. 예를 들어 GrowToBioFunctions를 실행하면 IPA는 화면 왼쪽 Grow 패널에 인과 분석 결과를 표로 펼쳐줍니다. z-score로 정렬한 뒤 관심 있는 항목만 골라 네트워크에 추가할 수 있습니다. 전부 자동으로 반영되는 것이 아니라, 연구자가 보고 싶은 것을 선택하는 방식입니다.
릴리즈 노트의 예시에서는 여기서 Differentiation of bone cells(뼈세포 분화)를 골라 네트워크에 더했습니다. 처음에 “왜 뼈가 여기 있지?”라고 물었던 질문이, 두 분화 과정이 같은 상위 신호를 공유한다는 관찰로 이어진 셈입니다.
2. 결과 창 없이 묻기 — Open Question
분석 결과 창이 없어도 물어볼 수 있습니다. 이때는 일반적인 과학 질문으로 받아들이고, 답변과 함께 그 답을 IPA 안에서 확인해 보는 방법을 제안합니다.
QIAGEN의 예시 질문은 다음과 같았습니다.
“GLP-1 계열 약물은 어떻게 비만을 감소시키나요?”
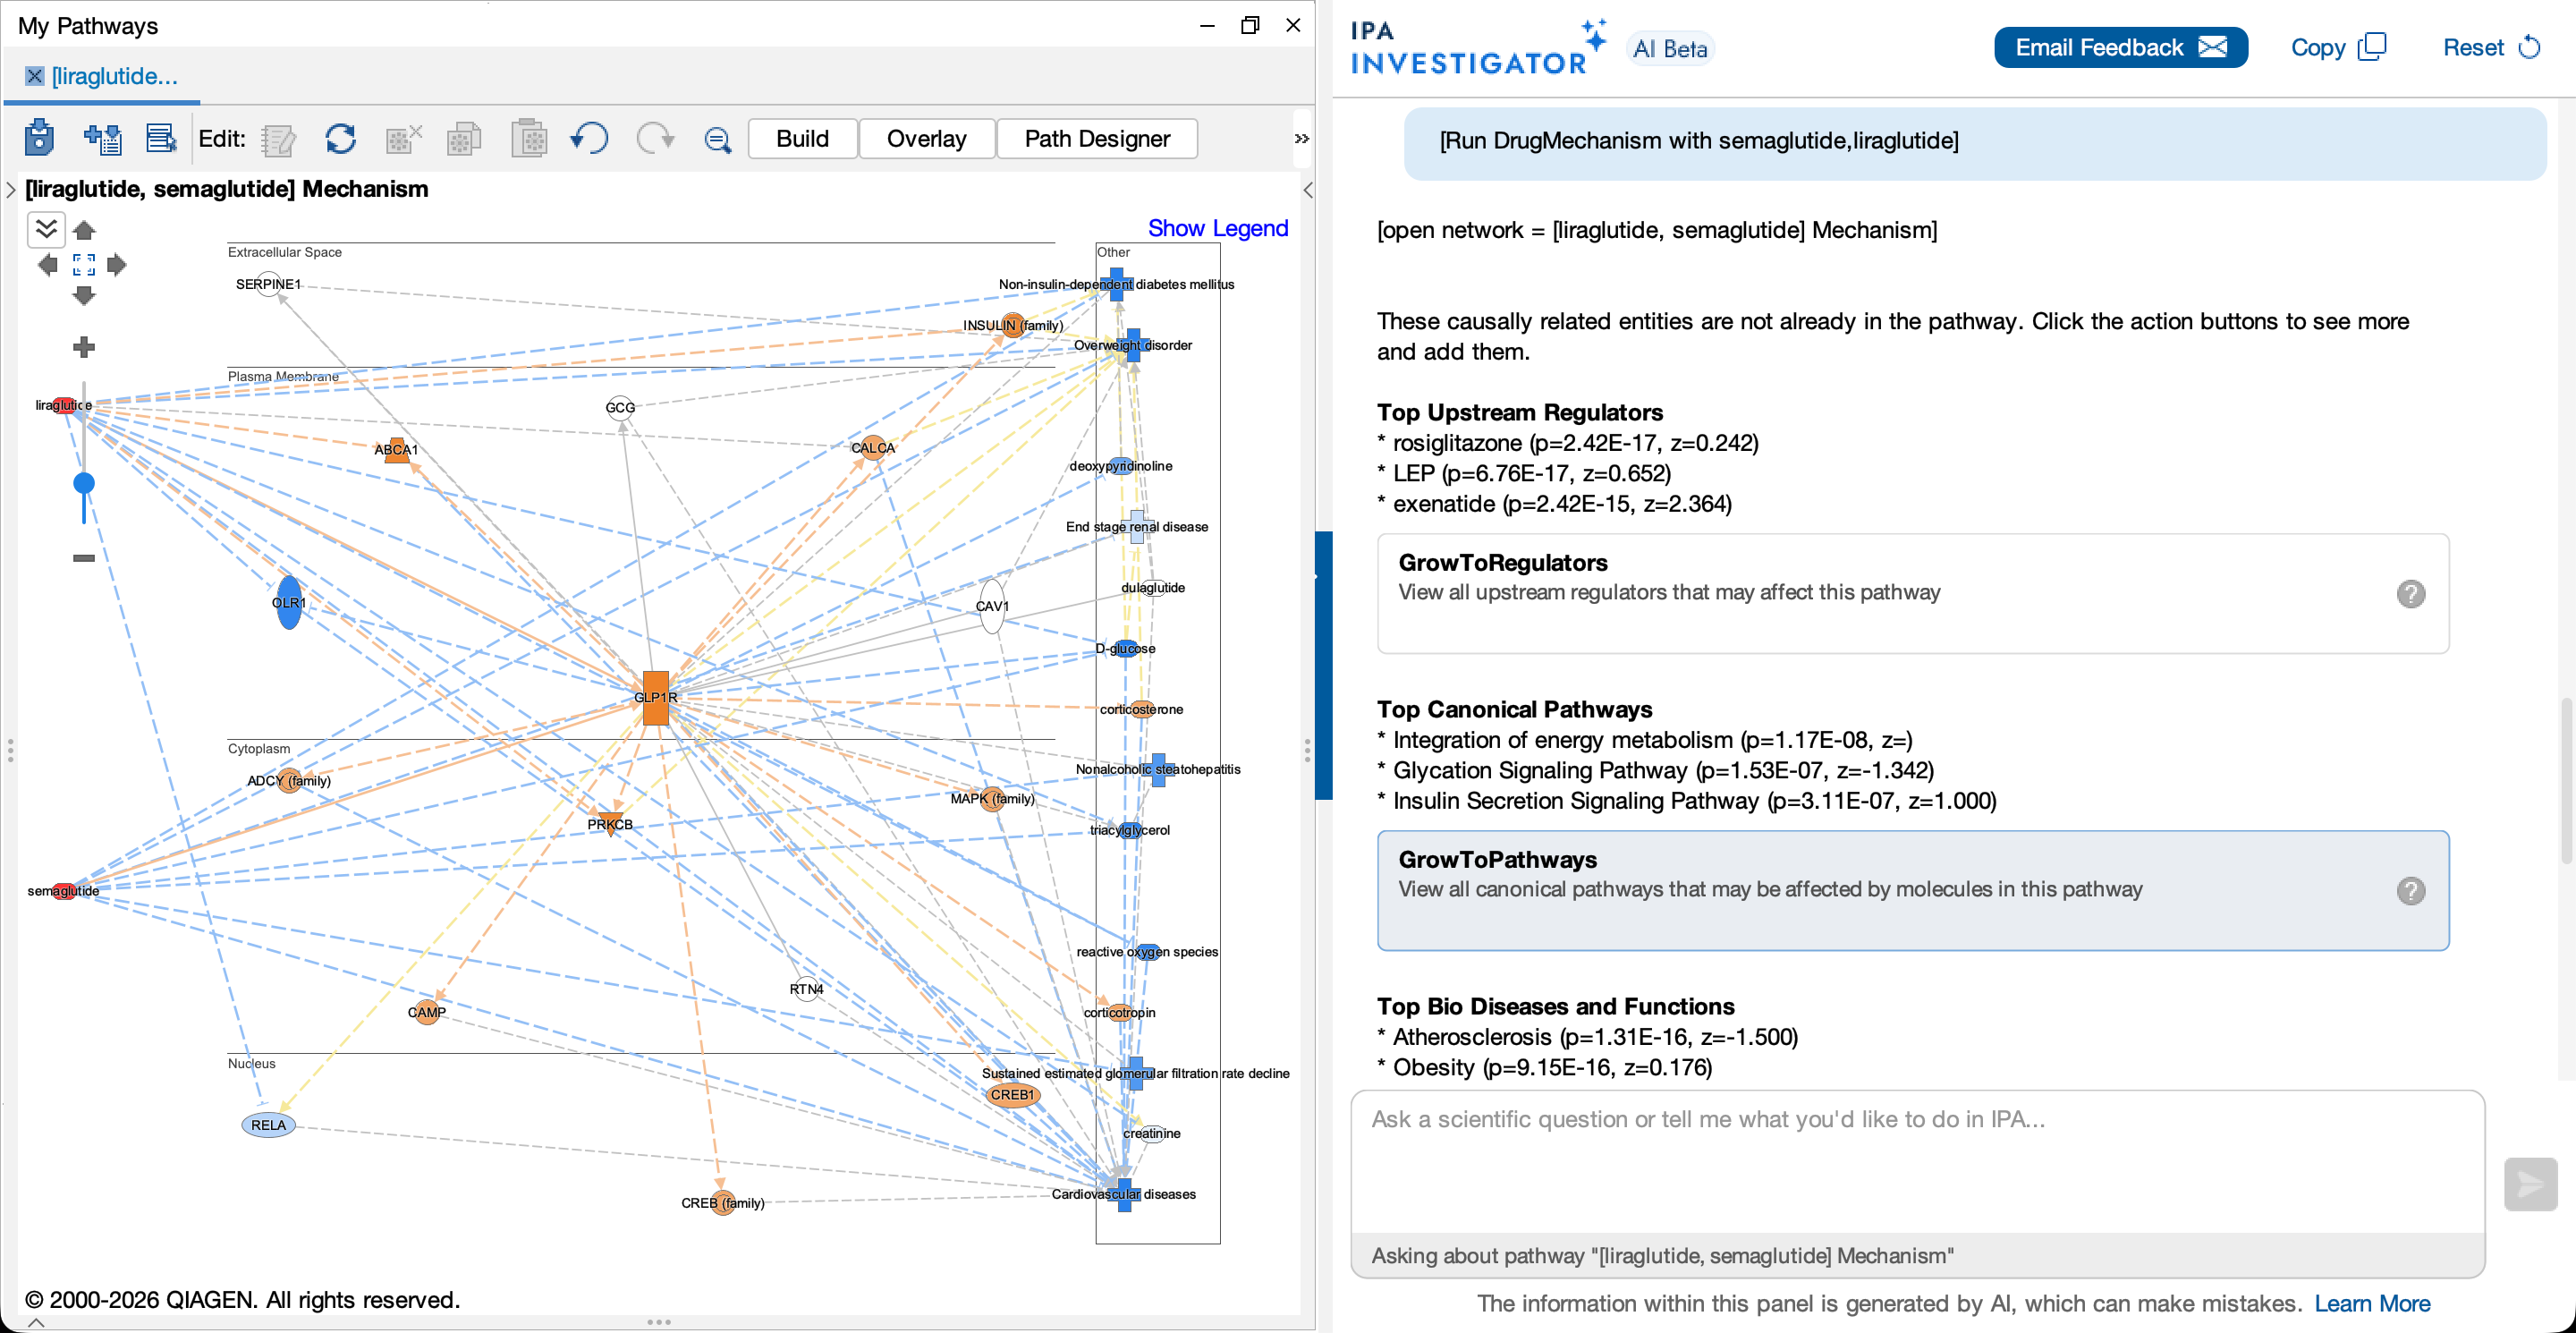
Drug Mechanism 액션으로 생성된 GLP-1 receptor agonists 네트워크
(출처: QIAGEN IPA and IPA Interpret Summer (2026) Release Notes)
패널에는 설명이 먼저 표시되고, 아래로 스크롤하면 Action Card가 나타납니다. 그중 Drug Mechanism Action Card를 실행하면 IPA가 잘 알려진 GLP-1 수용체 작용제를 중심에 둔 네트워크를 만들어 줍니다. 두 약물이 어떤 분자를 거쳐 어떤 기능으로 이어지는지가 문헌 근거로 그려지는 것입니다.
사실 이런 작업은 직접 해도 됩니다. 다만 메뉴를 여러 번 거쳐야 하는 경우가 많기 때문에 Investigator는 그 단계를 대신 실행하고 결과 화면을 띄워주는 역할을 합니다.
이 방식은 IPA를 막 시작한 연구자에게 특히 도움이 될 수 있습니다. 내가 하려는 작업이 IPA에서는 어떤 기능에 해당하는지를 찾는 데 드는 시간이 줄어들기 때문입니다.
3. 여러 분석을 나란히 놓고 묻기 — Comparison Analysis
4편에서 살펴봤던 Comparison Analysis, 즉 여러 분석 결과를 같은 기준 위에 나란히 놓고 비교하는 화면도 Investigator가 맥락으로 읽을 수 있습니다.
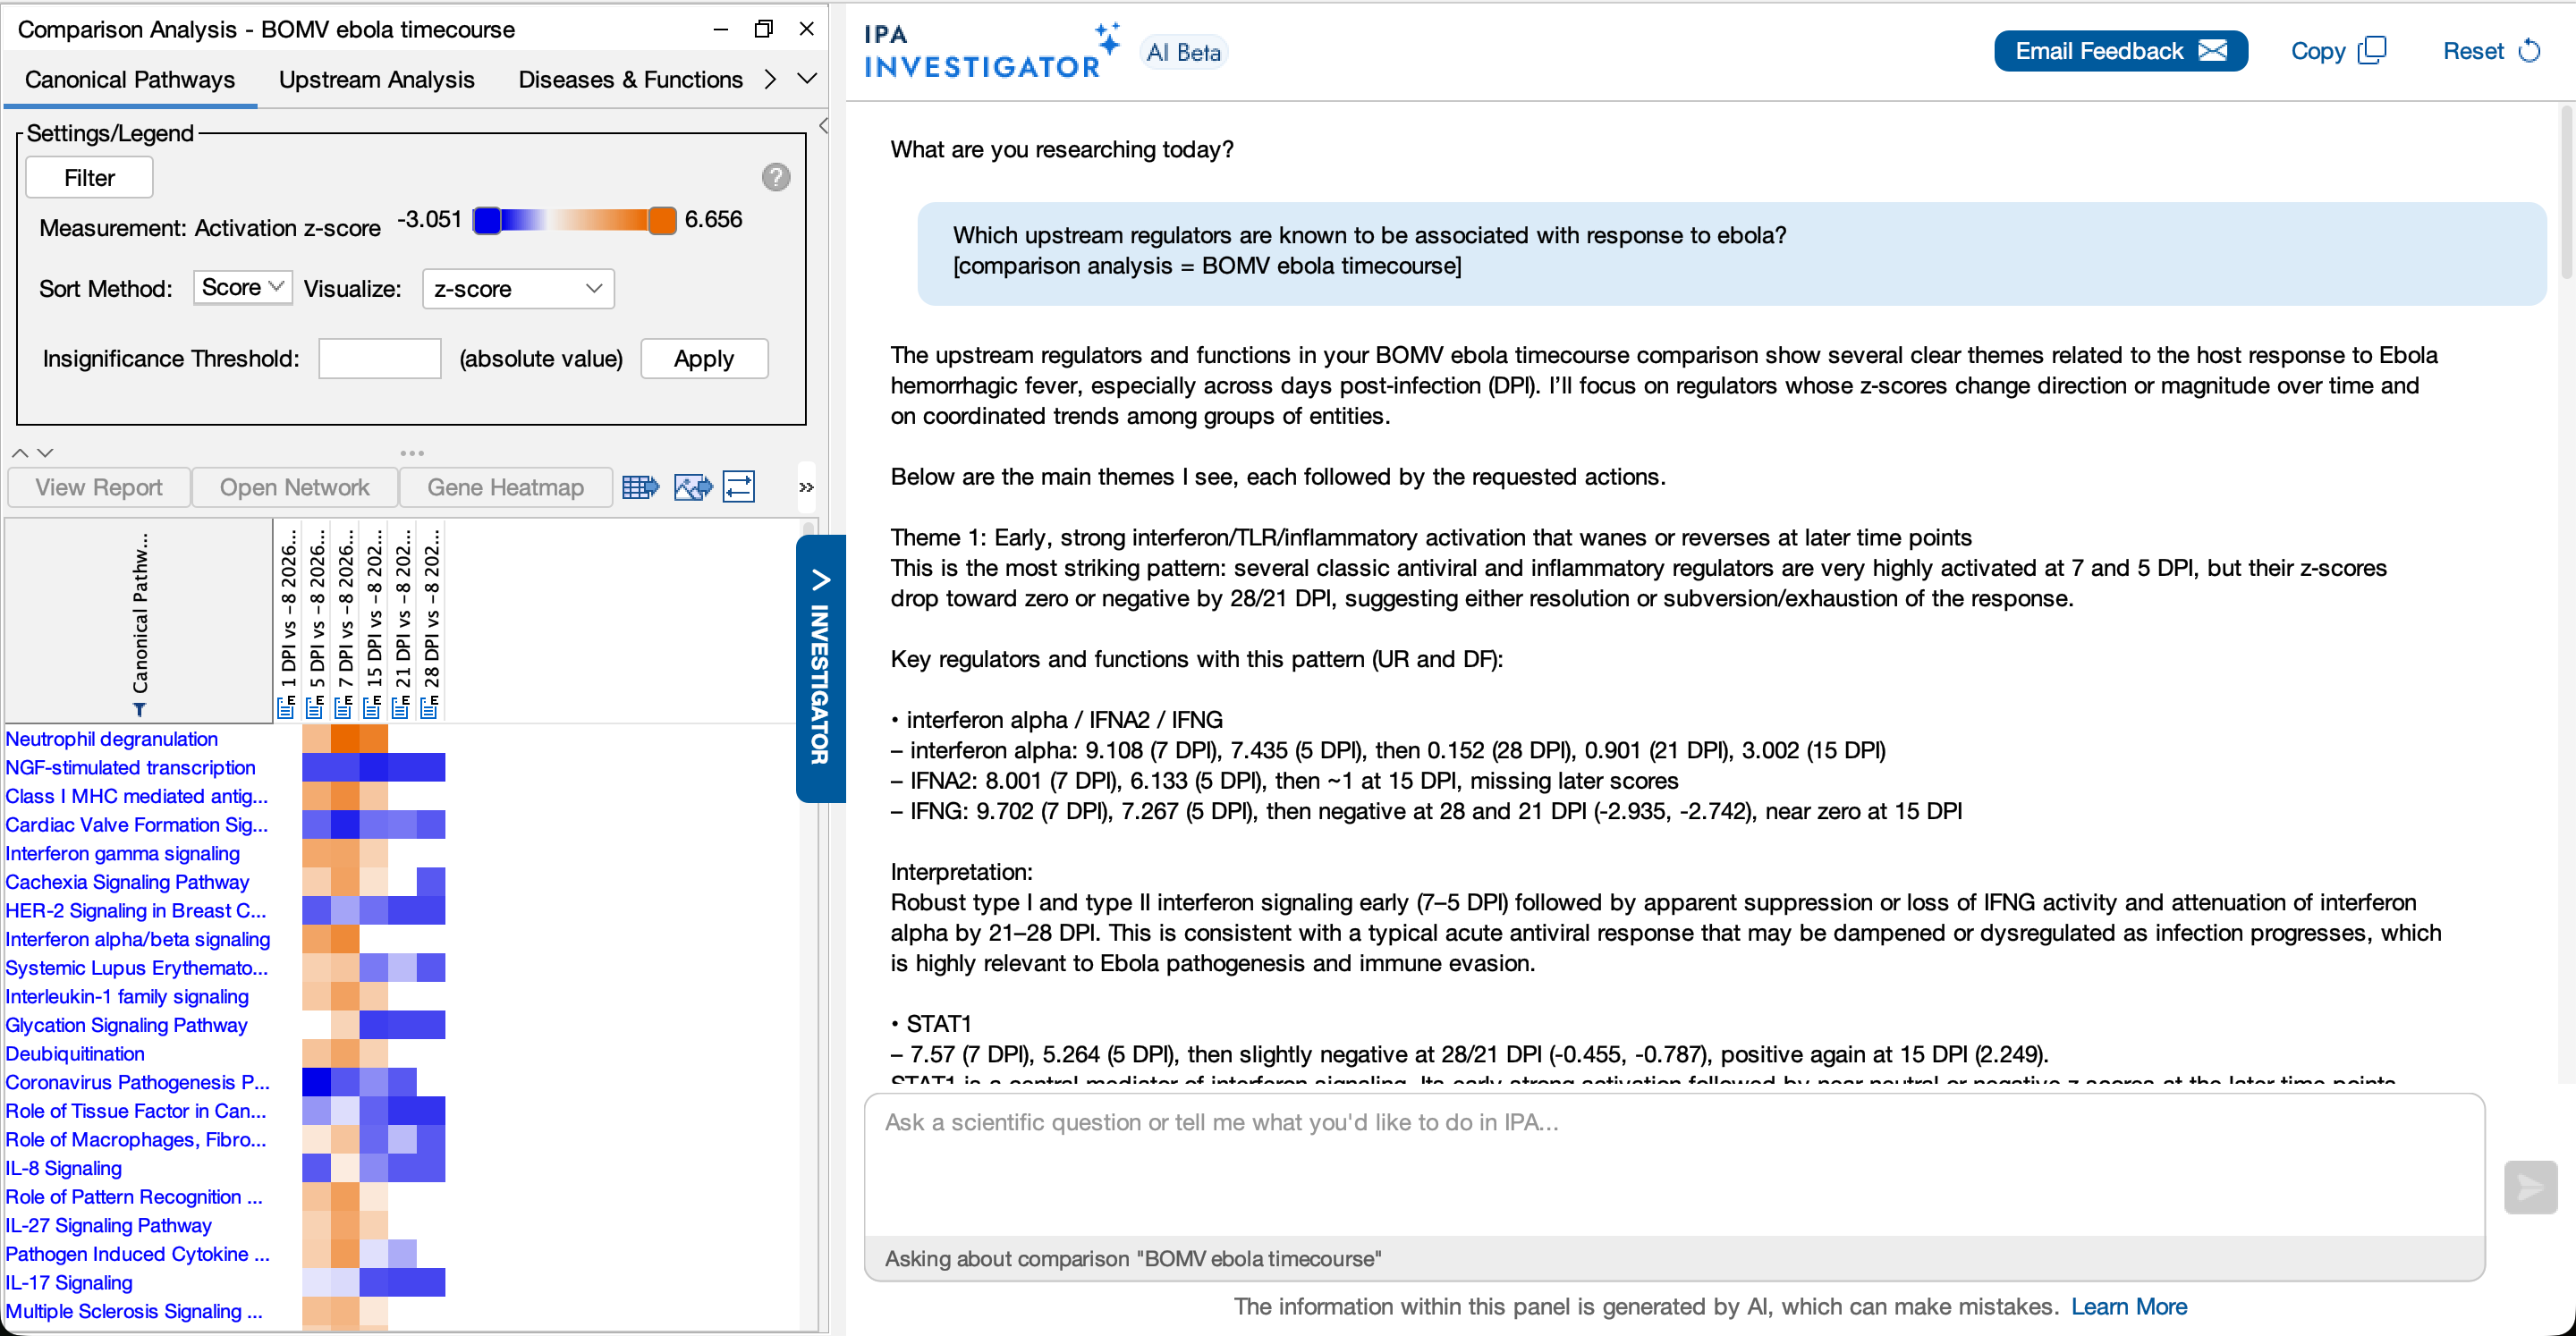
Comparison Analysis를 열어둔 상태에서 IPA Investigator에 질문하기
(출처: QIAGEN IPA and IPA Interpret Summer (2026) Release Notes)
릴리즈 노트의 예시는 BOMV 에볼라바이러스를 접종한 마카크 원숭이의 혈액 RNA-seq 데이터(GSE290671)를 분석하고 비교한 화면입니다. 여러 분석을 나란히 세운 상태에서 결과에 대해 질문하면, 설명과 함께 비교 결과를 필터링하는 Action Card가 제안됩니다.
여러 조건을 한 화면에 놓으면 정보가 많아 어디부터 볼지 정하기 어려울 때가 있습니다. “이 비교에서 반복되는 신호는 무엇인가”, “특정 반응과 관련된 항목만 보려면 어떻게 하나” 같은 질문을 화면 위에서 그대로 던져볼 수 있다는 점이 달라지는 지점입니다.
어디까지가 AI이고, 어디부터가 Knowledge Base인가
Investigator를 쓰기 전에 분명히 해두면 좋은 구분이 있습니다. 채팅 패널 안의 문장과 IPA 화면의 결과는 출처가 다릅니다.
| 구분 | 만든 주체 | 근거 |
| 채팅 패널 안의 설명 문장 | LLM (GPT-5.1) | 오류가 있을 수 있음 → 확인 필요 |
| 네트워크, 필터, Grow 등 IPA 화면의 결과 | IPA 자체 기능 | QIAGEN Knowledge Base |
대규모 언어모델의 특성상 채팅 패널의 문장에는 실수가 섞일 수 있습니다. 반면 패널 바깥에 표시되는 IPA Desktop의 결과는 IPA가 수행한 작업의 결과이며, QIAGEN Knowledge Base를 기반으로 합니다. 이 부분에는 AI가 직접 개입하지 않습니다.
지난 편에서 IPA Interpret의 AI 요약을 두고 이야기한 것과 같은 원칙입니다. AI가 내놓는 것은 결론이 아니라 해석을 시작하는 출발점이고, 검증은 연구자의 몫으로 남습니다.
내 데이터는 어디까지 전송되나
연구 데이터를 다루는 입장에서는 이 부분이 더 궁금할 수 있습니다. Investigator는 Microsoft Azure에서 QIAGEN 전용으로 호스팅되는 GPT-5.1을 사용합니다. 질문과 함께 현재 열려 있는 분석의 일부 결과 정보가 LLM에 전달될 수 있지만, 분석에 사용한 원본 데이터셋 자체가 전송되는 것은 아닙니다. 입력한 프롬프트는 보관되거나 모델 학습에 사용되지 않습니다.
쓰기 전에 알아두면 좋은 것
- 추가 비용은 없습니다. IPA 안에서 제공됩니다.
- 기본값은 꺼짐입니다. 연구에 AI를 사용하는 것에 대해 기관이나 개인이 가질 수 있는 우려를 고려해 비활성화 상태로 배포됩니다. 사용을 원할 경우 consulting@insilicogen.com으로 문의하시면 활성화 방법을 안내드리겠습니다.
- 현재 Beta입니다. 사용자 피드백을 반영해 기능을 다듬는 중이며, 추후 정식 버전으로 업데이트될 예정입니다.
마무리: 여덟 편을 지나, 다시 결과 화면 앞에서
지금까지 결과 화면 앞에서 생긴 질문을 IPA Investigator에게 어떻게 던지고, 그 답이 어떻게 분석으로 이어지는지 살펴봤습니다.
정리하면, IPA Investigator는 열려 있는 분석 결과를 맥락으로 읽고 질문에 답하며, 그 설명을 확인해 볼 수 있는 IPA 작업을 Action Card로 제안합니다. 실행한 뒤에는 다음에 해볼 만한 일을 다시 제시합니다. 이 과정에서 화면에 그려지는 결과는 모두 QIAGEN Knowledge Base에 근거합니다.
다만 한 가지는 분명히 해야 합니다. IPA Investigator가 연구자의 판단을 대신하지는 않습니다. 채팅 패널의 문장에는 오류가 섞일 수 있고, 어떤 질환인지, 어떤 조직과 세포인지, 어떤 실험 조건인지를 아는 사람은 결국 데이터를 만든 연구자입니다. 이 연재에서 계속 이야기해 온 것처럼, IPA가 내놓는 것은 확정된 답이 아니라 검증해야 할 가설입니다.
그럼에도 달라지는 지점은 분명합니다. “이 경로가 왜 여기 있지?”라는 질문을 결과 화면 앞에서 그대로 던져볼 수 있고, IPA 안에서 다음 단계로 이어갈 제안까지 함께 받을 수 있습니다. 필요할 때 꺼내 쓸 수 있는 선택지가 하나 늘어난 셈입니다.
이번 편을 끝으로 2026 IPA 시리즈를 마칩니다. 긴 유전자 목록 앞에서 막혔던 순간에서 출발해, 바이오마커 후보를 좁히고, 세포 타입별 조절자를 찾고, 여러 조건을 나란히 비교하고, 오래 보관해 둔 데이터를 다시 읽고, 서로 다른 오믹스를 하나의 이야기로 연결하고, 그 결과를 읽고 공유하는 방법까지 함께 살펴봤습니다.
여덟 편의 연재를 읽어주셔서 감사합니다. 여러분의 데이터도 긴 유전자 목록을 넘어, 새로운 해석과 가설로 이어지기를 바랍니다.
참고자료
• QIAGEN IPA and IPA Interpret Summer Release Q2 2026.pdf
• Latest improvements for IPA, 2026년 9월 10일 접속, https://digitalinsights.qiagen.com/products/qiagen-ipa/latest-improvements/current-line/?cmpid=QDI_GA_DISC_IPA
이미지 출처
- QIAGEN 웹사이트
- IPA Interpret
Ingenuity Pathway Analysis (IPA)에 대해 더 알아보고 싶으시거나 제품 데모, 활용 상담 및 도입을 고려하고 계신 경우,
consulting@insilicogen.com 또는 인실리코젠 홈페이지 1:1 문의를 통해 편하게 문의해 주세요.
더 많은 IPA 콘텐츠가 궁금하다면?
[2026 IPA 시리즈 제1편] 내 오믹스 데이터, '리스트'에서 '발견'으로: IPA로 읽는 생물학적 해석
[2026 IPA 시리즈 제2편] 수백 개 DEG 중 '진짜'를 찾는 법 — BioProfiler로 바이오마커 후보 좁히기
[2026 IPA 시리즈 제3편] UMAP까지는 그렸는데, 그 다음이 막혔다면 — scRNA-seq 클러스터를 '조절하는' Upstream Regulator
[2026 IPA 시리즈 제4편] 폐암에서 p53의 두 얼굴 — IPA로 비교해 본 LUAD와 LUSC의 경로 차이
[2026 IPA 시리즈 제5편] 오랫동안 보관 중인 Microarray 데이터, 이렇게 활용해 보세요
[2026 IPA 시리즈 제6편] 네 개의 오믹스, 하나의 생물학적 이야기
[2026 IPA 시리즈 제7편] 내 데이터, 더 빠르게 읽고 공유하기 — AI와 함께 읽는 IPA Interpret
EDITOR
황주현
iLAB · Junior Consultant
'STORAGE' 카테고리의 다른 글
| 수면의 과학 — 피곤한데 왜 잠은 안 올까? (0) | 2026.09.03 |
|---|---|
| [2026 IPA 시리즈 제7편] 내 데이터, 더 빠르게 읽고 공유하기 — AI와 함께 읽는 IPA Interpret (0) | 2026.08.27 |
| 끝나지 않은 식중독 시즌 — 식중독균의 정체와 예방법 (0) | 2026.08.24 |
| [2026 IPA 시리즈 제6편] 네 개의 오믹스, 하나의 생물학적 이야기 (0) | 2026.08.20 |
| [2026 IPA 시리즈 제5편] 오랫동안 보관 중인 Microarray 데이터, 이렇게 활용해 보세요 (0) | 2026.08.13 |


댓글